

Hello,我是小兔大白糖。 这篇整理面试口述与高频追问要点,方便对照站内同主题通识文。
TL;DR
Risk Scoring Platform 是连接实时/离线特征、ML 模型与业务决策的"风控大脑",核心使命是在 < 50ms 内完成从事件接入到风险分输出的全链路决策,并通过反馈闭环持续优化模型与规则。其本质是高并发、低延迟、强一致性的实时推理系统。
1. 概念定义(是什么)
1.1 风险评分平台(Risk Scoring Platform)
风险评分平台是一个将多源特征(实时 + 离线)、规则引擎与机器学习模型整合为统一风险分(Risk Score)的分布式系统。它接收来自交易、登录、提现等业务的事件流,经过特征工程、模型推理、规则融合后,输出可执行的风险决策(放行 / 挑战 / 拦截)。
类比:想象一个机场安检系统——乘客(事件)进入后,先通过 X 光机扫描行李(特征采集),再通过安检门检测金属(规则判定),最后由人工复核台综合判断风险等级(模型 + 决策融合),最终决定是否放行。风险评分平台就是这套系统的数字化、自动化版本。
1.2 特征(Feature)
特征是模型与规则的输入变量,分为三类:
- 实时特征(Real-time Features):当前请求的上下文,如 IP 地理位置、设备指纹、最近 1 小时交易次数。延迟要求 < 10ms。
- 近实时特征(Near-real-time Features):基于滑动窗口聚合,如最近 24 小时提现总额。延迟要求 < 1min。
- 离线特征(Offline Features):基于历史全量数据计算,如用户生命周期价值(LTV)、历史欺诈率。通常 T+1 更新。
1.3 模型服务(Model Serving)
将训练好的 ML 模型(XGBoost/LightGBM/Deep Learning)封装为低延迟推理服务。业界主流方案包括:
- NVIDIA Triton Inference Server:支持多框架(TensorRT/ONNX/PyTorch)、动态 batching、多版本热切换
- TensorFlow Serving:TF 生态专用,支持 gRPC/REST
- 自研 C++ 服务:极致性能场景,如 XGBoost 直接调用 C API
1.4 决策融合(Decision Fusion)
单一模型或规则都存在盲区:模型对未知攻击模式泛化强但不可解释;规则对已知模式精准但僵化。决策融合通过加权融合或层级覆盖将两者结合:
- Weighted Score Fusion:
final_score = α * rule_score + β * model_score - Cascading:规则先行拦截明显风险,模型处理模糊地带
1.5 反馈闭环(Feedback Loop)
风控系统的"生命线"。将决策结果(是否误杀/漏杀)回流到特征库与模型训练 pipeline,形成:
事件接入 → 决策 → 业务结果 → Label 生成 → 特征回填 → 模型重训 → 模型发布
没有反馈闭环的风控系统如同闭眼开车——迟早出事。
2. 核心原理与图解
2.1 需求分析
2.1.1 功能需求(Functional Requirements)
| 模块 | 需求描述 |
|---|---|
| 特征采集 | 实时接收 Kafka 事件流,离线对接 Hive/Spark 批量特征 |
| 特征存储 | 支持低延迟查询(Redis)与复杂 OLAP 查询(StarRocks) |
| 模型推理 | 支持多版本模型 A/B Test、灰度发布、热切换 |
| 决策融合 | 规则引擎 + 模型加权融合,支持动态调参 |
| 决策执行 | 输出 Risk Score + Action(PASS/CHALLENGE/BLOCK) |
| 反馈闭环 | 结果回流 Kafka,Label 聚合,模型自动重训触发 |
| 可观测性 | 全链路延迟监控、模型 PSI 漂移监控、特征缺失率监控 |
2.1.2 非功能需求(Non-Functional Requirements)
| 指标 | 目标值 | 说明 |
|---|---|---|
| P99 延迟 | < 50ms | 同步决策链路,直接影响交易体验 |
| 可用性 | 99.99% | 风控系统不可用 = 业务停摆 |
| 吞吐量 | 100K+ QPS | 支持 大型加密货币交易所 级别全球交易流量 |
| 模型推理延迟 | < 10ms | XGBoost 小模型或 TensorRT 优化后 |
| 特征查询延迟 | < 5ms | Redis P99,StarRocks P99 < 20ms |
| 一致性 | 最终一致 | 实时特征强一致,离线特征 T+1 可接受 |
2.1.3 容量估算
以 大型加密货币交易所 量级为例:
- 峰值事件量:100K events/sec(交易、登录、提现、KYC 等汇总)
- 特征存储:
- Redis:每特征平均 128B,1M 用户 × 100 特征 ≈ 12.8GB(热数据)
- StarRocks:历史特征宽表,PB 级,按用户/时间分区
- 模型推理:每事件平均调用 2~3 个模型,峰值 300K infer/sec
- 带宽估算:Kafka 入站 200MB/s(假设单事件 2KB),出站 100MB/s
2.2 系统架构图

2.3 数据流时序图
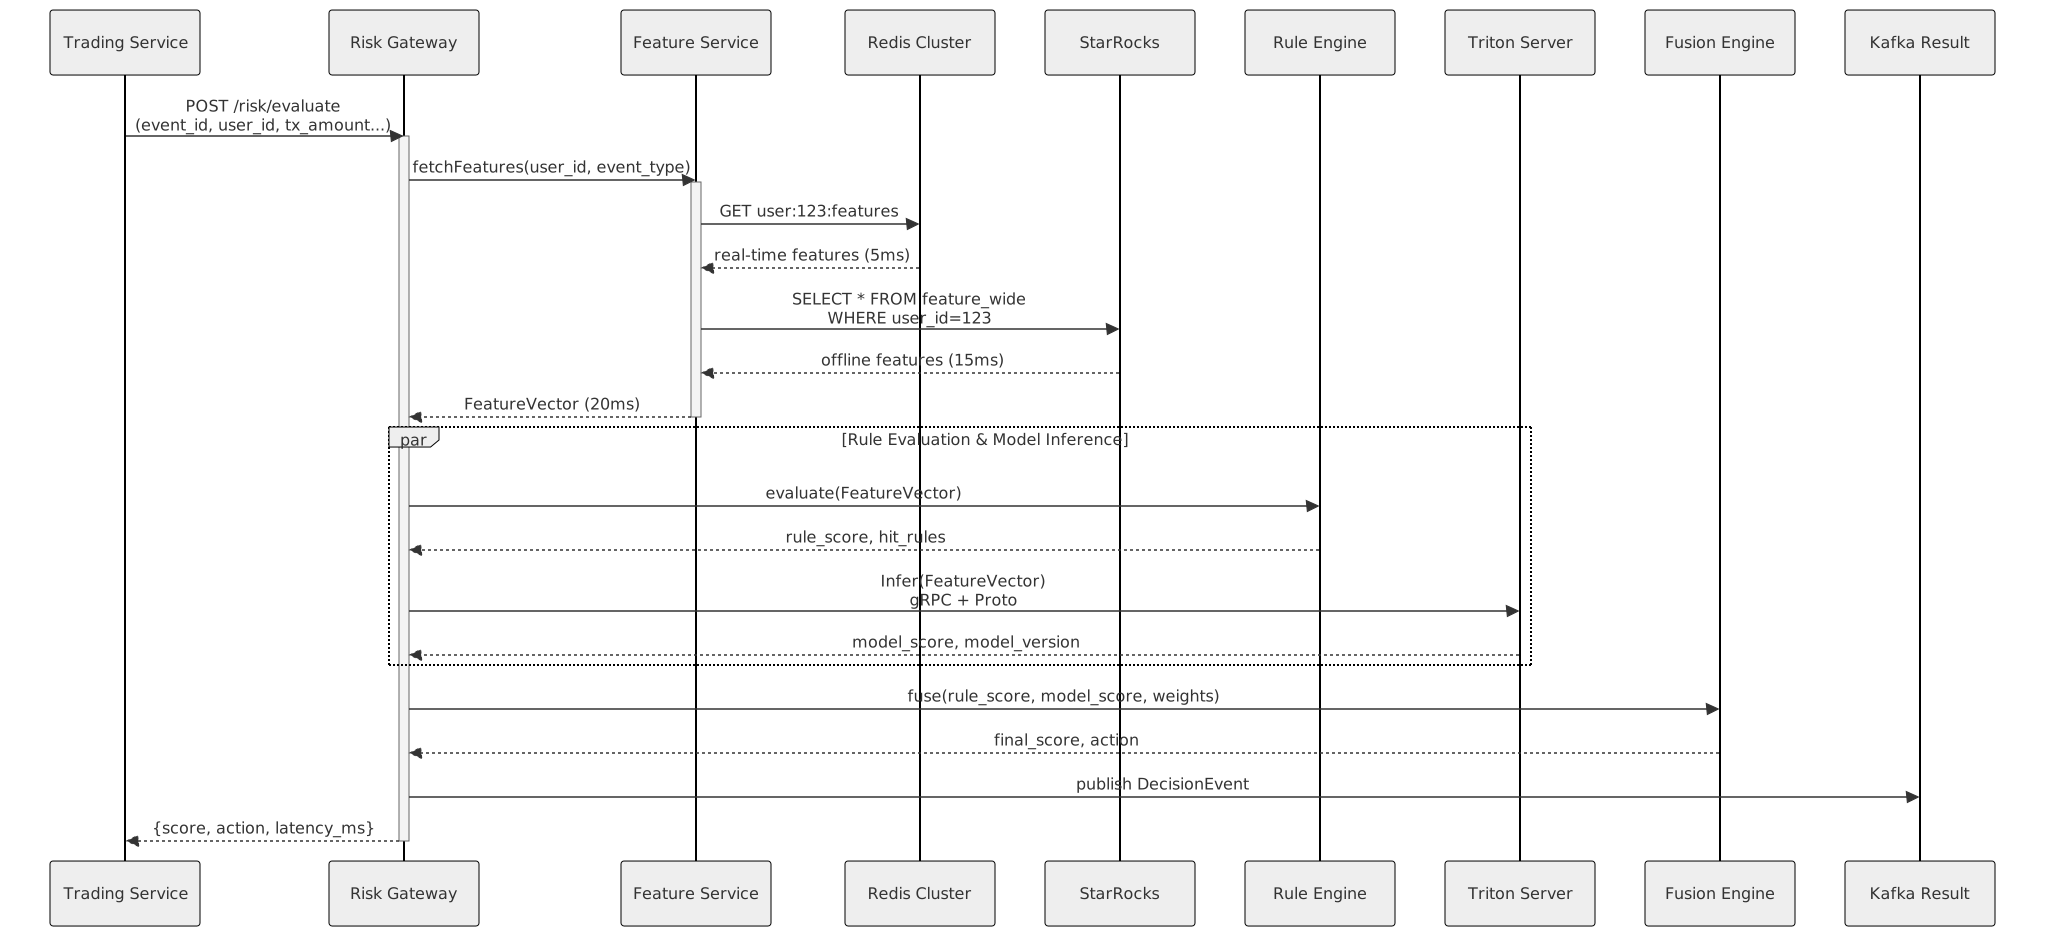
2.4 存储设计
2.4.1 Redis 实时特征存储
Key Design:
  user:{user_id}:rt      -> Hash {feature_name: value}
  user:{user_id}:window  -> ZSET (sliding window events, scored by timestamp)
  device:{device_id}:fp  -> Hash {fingerprint_features}
  ip:{ip}:geo            -> String {country, city, asn}

TTL Strategy:
  - 实时特征:24h
  - 滑动窗口:7d
  - 设备指纹:30d
2.4.2 StarRocks 离线特征宽表
CREATE TABLE feature_wide (
    user_id BIGINT,
    event_date DATE,
    lifetime_tx_count BIGINT,
    lifetime_tx_amount DECIMAL(38, 8),
    avg_tx_amount_30d DECIMAL(38, 8),
    unique_counterparties_30d INT,
    kyc_level INT,
    account_age_days INT,
    -- 分区与模型特征
    dt DATE
)
DUPLICATE KEY(user_id, event_date)
PARTITION BY RANGE(dt) ()
DISTRIBUTED BY HASH(user_id) BUCKETS 128
PROPERTIES ("replication_num" = "3");
2.5 关键设计决策
| 决策点 | 选型 | 理由 |
|---|---|---|
| 实时特征计算 | Flink over Spark Streaming | Flink 的 Checkpoint 机制提供更稳定的 Exactly-Once,Event Time 语义对乱序事件更友好 |
| 实时缓存 | Redis Cluster | 亚毫秒级查询,支持 Hash/ZSET 结构天然适合特征存储 |
| OLAP 存储 | StarRocks | MPP 架构 + 向量化执行,单表查询 P99 < 20ms;支持物化视图加速常用特征 |
| 模型服务 | Triton | 多框架支持,动态 batching 提升 GPU 利用率,gRPC 低延迟 |
| 规则引擎 | 自研 DSL + Aviator / Drools | 自研 DSL 更轻量,Drools Rete 算法适合复杂规则网络 |
| 消息总线 | Kafka | 高吞吐、持久化、支持回溯,便于反馈闭环与审计 |
3. 语法详解与代码示例(怎么用)
3.1 特征采集 Pipeline(Kafka Consumer)
package com.大型加密货币交易所.risk.ingestion;

import org.apache.kafka.clients.consumer.*;
import org.apache.kafka.common.serialization.StringDeserializer;
import org.springframework.stereotype.Component;

import javax.annotation.PostConstruct;
import javax.annotation.PreDestroy;
import java.time.Duration;
import java.util.*;
import java.util.concurrent.*;

/**
 * 实时特征采集消费者:从 Kafka Raw Events 消费,提取特征并写入 Redis。
 * 设计要点:
 * 1. 多线程消费,单线程内单分区顺序处理保证 Event Time 语义
 * 2. 批量写入 Redis(Pipeline)降低 RTT
 * 3. 手动提交 Offset,失败时重试
 */
@Component
public class RealtimeFeatureConsumer {

    private static final String TOPIC = "risk.raw.events";
    private static final String GROUP_ID = "risk-feature-consumer-v2";
    private static final int CONSUMER_THREADS = 16;

    private final ExecutorService executor = Executors.newFixedThreadPool(CONSUMER_THREADS);
    private final List<KafkaConsumer<String, String>> consumers = new CopyOnWriteArrayList<>();
    private final FeatureExtractor featureExtractor;
    private final RedisFeatureStore redisFeatureStore;
    private volatile boolean running = true;

    public RealtimeFeatureConsumer(FeatureExtractor featureExtractor,
                                   RedisFeatureStore redisFeatureStore) {
        this.featureExtractor = featureExtractor;
        this.redisFeatureStore = redisFeatureStore;
    }

    @PostConstruct
    public void start() {
        for (int i = 0; i < CONSUMER_THREADS; i++) {
            final int threadId = i;
            executor.submit(() -> consume(threadId));
        }
    }

    private void consume(int threadId) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "kafka.risk.svc:9092");
        props.put(ConsumerConfig.GROUP_ID_CONFIG, GROUP_ID);
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        props.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 500);
        props.put(ConsumerConfig.SESSION_TIMEOUT_MS_CONFIG, 30000);

        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);
        consumers.add(consumer);
        consumer.subscribe(Collections.singletonList(TOPIC));

        try {
            while (running) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
                if (records.isEmpty()) continue;

                List<FeatureRecord> featureBatch = new ArrayList<>(records.count());
                for (ConsumerRecord<String, String> record : records) {
                    try {
                        RiskEvent event = RiskEvent.parse(record.value());
                        List<FeatureRecord> features = featureExtractor.extract(event);
                        featureBatch.addAll(features);
                    } catch (Exception e) {
                        // 单条异常不阻塞批次,记录 DLQ
                        log.error("Feature extract failed, offset={}", record.offset(), e);
                        sendToDLQ(record);
                    }
                }

                // Pipeline 批量写入 Redis,减少网络 RTT
                if (!featureBatch.isEmpty()) {
                    redisFeatureStore.batchWrite(featureBatch);
                }

                // 同步提交 Offset,确保特征不丢失
                consumer.commitSync();
            }
        } finally {
            consumer.close();
        }
    }

    @PreDestroy
    public void shutdown() {
        running = false;
        consumers.forEach(KafkaConsumer::wakeup);
        executor.shutdown();
        try {
            if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {
                executor.shutdownNow();
            }
        } catch (InterruptedException e) {
            executor.shutdownNow();
        }
    }
}
3.2 特征服务(Feature Service:Redis + StarRocks 查询)
package com.大型加密货币交易所.risk.feature;

import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;
import org.springframework.stereotype.Service;

import java.util.*;
import java.util.concurrent.TimeUnit;

/**
 * 统一特征查询服务:
 * 1. L1:本地 Caffeine Cache(防热点、降 Redis 压力)
 * 2. L2:Redis Cluster(实时特征)
 * 3. L3:StarRocks(离线特征宽表)
 *
 * 降级策略:StarRocks 超时或不可用时,仅使用实时特征 + 默认值,保证服务可用。
 */
@Service
public class FeatureService {

    // L1 本地缓存:用户级特征热点防护,TTL 5s
    private final Cache<String, FeatureVector> localCache = Caffeine.newBuilder()
            .maximumSize(100_000)
            .expireAfterWrite(5, TimeUnit.SECONDS)
            .recordStats()
            .build();

    private final RedisFeatureStore redisStore;
    private final StarRocksFeatureRepository starRocksRepo;
    private final FeatureFallbackFactory fallbackFactory;

    public FeatureService(RedisFeatureStore redisStore,
                          StarRocksFeatureRepository starRocksRepo,
                          FeatureFallbackFactory fallbackFactory) {
        this.redisStore = redisStore;
        this.starRocksRepo = starRocksRepo;
        this.fallbackFactory = fallbackFactory;
    }

    public FeatureVector fetch(String userId, String eventType) {
        String cacheKey = userId + ":" + eventType;

        // L1 本地缓存
        FeatureVector cached = localCache.getIfPresent(cacheKey);
        if (cached != null) {
            Metrics.counter("feature.cache.l1.hit").increment();
            return cached;
        }

        // L2 Redis 实时特征
        FeatureVector.Builder builder = FeatureVector.newBuilder();
        Map<String, Object> realTimeFeatures = redisStore.getUserFeatures(userId);
        builder.putAll(realTimeFeatures);

        // L3 StarRocks 离线特征(带熔断降级)
        try {
            Map<String, Object> offlineFeatures = starRocksRepo.queryByUserId(userId);
            builder.putAll(offlineFeatures);
        } catch (Exception e) {
            log.warn("StarRocks query failed, using fallback. userId={}", userId, e);
            Map<String, Object> fallback = fallbackFactory.getDefaults(eventType);
            builder.putAll(fallback);
            Metrics.counter("feature.starrocks.fallback").increment();
        }

        FeatureVector result = builder.build();
        localCache.put(cacheKey, result);
        return result;
    }
}
3.3 模型服务客户端(Triton gRPC)
package com.大型加密货币交易所.risk.model;

import inference.GRPCInferenceServiceGrpc;
import inference.GrpcService.*;
import io.grpc.ManagedChannel;
import io.grpc.ManagedChannelBuilder;
import io.grpc.netty.shaded.io.grpc.netty.NettyChannelBuilder;
import io.micrometer.core.instrument.Timer;
import org.springframework.stereotype.Component;

import javax.annotation.PreDestroy;
import java.util.*;
import java.util.concurrent.TimeUnit;

/**
 * Triton Inference Server gRPC 客户端:
 * 1. 支持多模型版本 A/B Test(通过 model_version 头指定)
 * 2. 动态 batching:小流量时累积 batch,降低 GPU 启动开销
 * 3. 熔断降级:超时或异常时 fallback 到规则分数
 */
@Component
public class TritonModelClient {

    private static final String TRITON_HOST = "triton.risk.svc";
    private static final int TRITON_PORT = 8001;
    private static final long TIMEOUT_MS = 20;

    private final ManagedChannel channel;
    private final GRPCInferenceServiceGrpc.GRPCInferenceServiceBlockingStub stub;
    private final ModelRegistry modelRegistry;

    public TritonModelClient(ModelRegistry modelRegistry) {
        this.modelRegistry = modelRegistry;
        this.channel = NettyChannelBuilder.forAddress(TRITON_HOST, TRITON_PORT)
                .usePlaintext()
                .maxRetryAttempts(3)
                .build();
        this.stub = GRPCInferenceServiceGrpc.newBlockingStub(channel)
                .withDeadlineAfter(TIMEOUT_MS, TimeUnit.MILLISECONDS);
    }

    /**
     * 单条推理,实际生产环境使用 batchInfer 批量推理。
     */
    public ModelResult infer(String modelName, String modelVersion, FeatureVector features) {
        Timer.Sample sample = Timer.start();
        try {
            // 构造 Triton Infer 请求
            ModelInferRequest.InferInputTensor inputTensor = buildInputTensor(features);
            ModelInferRequest request = ModelInferRequest.newBuilder()
                    .setModelName(modelName)
                    .setModelVersion(modelVersion)
                    .addInputs(inputTensor)
                    .build();

            ModelInferResponse response = stub.modelInfer(request);
            float riskScore = parseOutput(response);

            sample.stop(Timer.builder("triton.infer.latency")
                    .tag("model", modelName)
                    .tag("version", modelVersion)
                    .register(Metrics.globalRegistry));

            return ModelResult.builder()
                    .score(riskScore)
                    .modelName(modelName)
                    .modelVersion(modelVersion)
                    .build();
        } catch (Exception e) {
            Metrics.counter("triton.infer.error", "model", modelName).increment();
            throw new ModelInferenceException("Triton inference failed: " + modelName, e);
        }
    }

    /**
     * 批量推理:通过动态 batching 提升吞吐。
     */
    public List<ModelResult> batchInfer(String modelName, String modelVersion,
                                         List<FeatureVector> batch) {
        if (batch.isEmpty()) return Collections.emptyList();

        ModelInferRequest.InferInputTensor inputTensor = buildBatchInputTensor(batch);
        ModelInferRequest request = ModelInferRequest.newBuilder()
                .setModelName(modelName)
                .setModelVersion(modelVersion)
                .addInputs(inputTensor)
                .build();

        ModelInferResponse response = stub.modelInfer(request);
        return parseBatchOutput(response, modelName, modelVersion, batch.size());
    }

    private ModelInferRequest.InferInputTensor buildInputTensor(FeatureVector features) {
        // 将 FeatureVector 序列化为 FP32 tensor
        // shape: [1, feature_dim]
        return ModelInferRequest.InferInputTensor.newBuilder()
                .setName("input")
                .setDatatype("FP32")
                .addShape(1)
                .addShape(features.getDim())
                .setContents(buildTensorContents(features))
                .build();
    }

    @PreDestroy
    public void shutdown() {
        channel.shutdown();
    }
}
3.4 决策融合引擎(Rule + Model Weighted Fusion)
package com.大型加密货币交易所.risk.decision;

import org.springframework.stereotype.Component;

import java.util.*;

/**
 * 决策融合引擎:
 * 1. 规则引擎先行:硬规则直接 BLOCK(如黑名单、超高频交易)
 * 2. 模型分数补充:对模糊地带进行风险评分
 * 3. 加权融合:支持动态权重调整(通过配置中心实时推送)
 * 4. 决策输出:RiskScore [0, 100] + Action(PASS/CHALLENGE/BLOCK)
 *
 * 类比:就像医院急诊分诊——护士(规则)先筛查危重病人直接送抢救室,
 *      医生(模型)再对剩余病人做进一步检查打分,最后综合决定就诊优先级。
 */
@Component
public class DecisionFusionEngine {

    private final RuleEngine ruleEngine;
    private final WeightConfigRepository weightConfigRepo;

    public DecisionFusionEngine(RuleEngine ruleEngine,
                                WeightConfigRepository weightConfigRepo) {
        this.ruleEngine = ruleEngine;
        this.weightConfigRepo = weightConfigRepo;
    }

    public DecisionResult evaluate(RiskEvent event, FeatureVector features) {
        // Stage 1: 规则引擎硬拦截
        RuleResult ruleResult = ruleEngine.evaluate(event, features);
        if (ruleResult.getAction() == Action.BLOCK) {
            return DecisionResult.builder()
                    .score(100.0)
                    .action(Action.BLOCK)
                    .reason("Hard rule hit: " + ruleResult.getHitRules())
                    .build();
        }

        // Stage 2: 模型推理(批量调用多个子模型)
        List<ModelResult> modelResults = invokeModels(event, features);

        // Stage 3: 加权融合
        double finalScore = fuseScores(ruleResult, modelResults, event.getEventType());

        // Stage 4: Action 映射
        Action action = mapAction(finalScore, ruleResult);

        return DecisionResult.builder()
                .score(finalScore)
                .action(action)
                .ruleScore(ruleResult.getScore())
                .modelScores(modelResults.stream()
                        .collect(Collectors.toMap(ModelResult::getModelName, ModelResult::getScore)))
                .build();
    }

    private double fuseScores(RuleResult ruleResult, List<ModelResult> modelResults, String eventType) {
        WeightConfig config = weightConfigRepo.getConfig(eventType);

        double weightedModelScore = modelResults.stream()
                .mapToDouble(m -> m.getScore() * config.getModelWeight(m.getModelName()))
                .sum();

        // 归一化模型权重
        double totalModelWeight = modelResults.stream()
                .mapToDouble(m -> config.getModelWeight(m.getModelName()))
                .sum();
        if (totalModelWeight > 0) {
            weightedModelScore /= totalModelWeight;
        }

        // 规则分数与模型分数融合
        double fused = config.getRuleWeight() * ruleResult.getScore()
                     + (1 - config.getRuleWeight()) * weightedModelScore;

        return Math.min(100.0, Math.max(0.0, fused));
    }

    private Action mapAction(double finalScore, RuleResult ruleResult) {
        if (finalScore >= 90.0 || ruleResult.getAction() == Action.BLOCK) {
            return Action.BLOCK;
        } else if (finalScore >= 60.0) {
            return Action.CHALLENGE; // 2FA / CAPTCHA / 人工审核
        }
        return Action.PASS;
    }

    private List<ModelResult> invokeModels(RiskEvent event, FeatureVector features) {
        // 并行调用多个模型,CompletableFuture 聚合
        // 实际代码使用 ExecutorService + CompletableFuture.allOf
        // 此处省略线程池细节
        return Arrays.asList(
                modelClient.infer("xgb_tx_v3", "3.1", features),
                modelClient.infer("dnn_behavior_v2", "2.0", features)
        );
    }
}
3.5 反馈闭环(结果回流 + Label 收集)
package com.大型加密货币交易所.risk.feedback;

import org.apache.kafka.clients.producer.*;
import org.springframework.stereotype.Service;

import java.util.*;
import java.util.concurrent.*;

/**
 * 反馈闭环服务:
 * 1. 决策结果实时回流 Kafka(risk.decision.result)
 * 2. Label Collector 监听 Chargeback、申诉、人工审核结果,生成 Ground Truth
 * 3. PSI Monitor 监控模型漂移,触发重训
 * 4. 特征回填:将决策时的特征快照持久化到 Hive,用于离线训练
 */
@Service
public class FeedbackLoopService {

    private static final String DECISION_TOPIC = "risk.decision.result";
    private static final String FEATURE_SNAPSHOT_TOPIC = "risk.feature.snapshot";

    private final KafkaProducer<String, String> producer;
    private final LabelCollector labelCollector;
    private final PsiMonitor psiMonitor;
    private final FeatureSnapshotStore snapshotStore;

    public FeedbackLoopService(LabelCollector labelCollector,
                               PsiMonitor psiMonitor,
                               FeatureSnapshotStore snapshotStore) {
        this.labelCollector = labelCollector;
        this.psiMonitor = psiMonitor;
        this.snapshotStore = snapshotStore;

        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "kafka.risk.svc:9092");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.ACKS_CONFIG, "all");
        props.put(ProducerConfig.COMPRESSION_TYPE_CONFIG, "lz4");
        this.producer = new KafkaProducer<>(props);
    }

    /**
     * 决策结果回流:交易服务异步上报最终业务结果(成功/失败/拒付)。
     */
    public void emitDecision(DecisionResult decision, RiskEvent event, FeatureVector features) {
        DecisionRecord record = DecisionRecord.builder()
                .eventId(event.getEventId())
                .userId(event.getUserId())
                .timestamp(System.currentTimeMillis())
                .score(decision.getScore())
                .action(decision.getAction().name())
                .modelVersions(decision.getModelScores().keySet())
                .build();

        producer.send(new ProducerRecord<>(DECISION_TOPIC, event.getEventId(), record.toJson()));

        // 特征快照:用于后续模型训练与审计
        FeatureSnapshot snapshot = FeatureSnapshot.builder()
                .eventId(event.getEventId())
                .features(features.toMap())
                .build();
        snapshotStore.save(snapshot);
        producer.send(new ProducerRecord<>(FEATURE_SNAPSHOT_TOPIC, event.getEventId(), snapshot.toJson()));
    }

    /**
     * Label 收集:定期聚合 Chargeback 与申诉数据,生成训练样本。
     */
    public void syncLabels() {
        List<ChargebackEvent> chargebacks = labelCollector.fetchRecentChargebacks(Duration.ofDays(7));
        for (ChargebackEvent cb : chargebacks) {
            // 回填 Label:1=欺诈, 0=正常
            snapshotStore.updateLabel(cb.getEventId(), cb.isFraud() ? 1 : 0);
        }

        // 触发模型重训评估
        if (shouldRetrain()) {
            triggerRetrainingPipeline();
        }
    }

    private boolean shouldRetrain() {
        double psi = psiMonitor.calculatePsi("xgb_tx_v3");
        return psi > 0.25; // PSI > 0.25 认为模型漂移严重
    }

    private void triggerRetrainingPipeline() {
        // 调用 Airflow / Kubeflow Pipeline API 触发重训
        // 新模型训练完成后走灰度发布流程
        log.info("Triggering model retraining pipeline due to PSI drift");
        MlopsClient.triggerPipeline("risk_tx_model_retrain", Map.of("base_dt", getYesterday()));
    }
}
3.6 API 定义
package com.大型加密货币交易所.risk.api;

import org.springframework.web.bind.annotation.*;

import javax.validation.Valid;

/**
 * Risk Scoring Platform 对外暴露的 RESTful API。
 * 内部服务间调用使用 gRPC(更低延迟)。
 */
@RestController
@RequestMapping("/api/v1/risk")
public class RiskScoringController {

    private final DecisionFusionEngine fusionEngine;
    private final FeatureService featureService;
    private final FeedbackLoopService feedbackLoop;

    @PostMapping("/evaluate")
    public RiskEvaluateResponse evaluate(@Valid @RequestBody RiskEvaluateRequest request) {
        long start = System.currentTimeMillis();

        // 1. 特征查询
        FeatureVector features = featureService.fetch(request.getUserId(), request.getEventType());

        // 2. 构建事件
        RiskEvent event = RiskEvent.fromRequest(request);

        // 3. 决策融合
        DecisionResult decision = fusionEngine.evaluate(event, features);

        // 4. 异步反馈(不阻塞响应)
        feedbackLoop.emitDecision(decision, event, features);

        long latency = System.currentTimeMillis() - start;
        Metrics.timer("risk.evaluate.latency").record(latency, TimeUnit.MILLISECONDS);

        return RiskEvaluateResponse.builder()
                .eventId(request.getEventId())
                .score(decision.getScore())
                .action(decision.getAction())
                .latencyMs(latency)
                .build();
    }

    @PostMapping("/feedback")
    public void receiveFeedback(@Valid @RequestBody RiskFeedbackRequest request) {
        // 业务方异步上报最终结果(如 Chargeback)
        feedbackLoop.receiveBusinessFeedback(request);
    }

    @GetMapping("/model/{modelName}/psi")
    public PsiReport getPsiReport(@PathVariable String modelName) {
        return feedbackLoop.getPsiMonitor().generateReport(modelName);
    }
}

// DTOs
@Data
@Builder
class RiskEvaluateRequest {
    @NotBlank private String eventId;
    @NotBlank private String userId;
    @NotBlank private String eventType; // TX, WITHDRAW, LOGIN, KYC
    private BigDecimal amount;
    private String currency;
    private String sourceIp;
    private String deviceId;
    private Map<String, Object> extra;
}

@Data
@Builder
class RiskEvaluateResponse {
    private String eventId;
    private double score;
    private Action action;
    private long latencyMs;
}
4. 业界案例
4.1 阿里巴巴:蚂蚁集团 AlphaRisk
蚂蚁集团的 AlphaRisk 是业界公认的风控标杆。其核心架构与本设计高度相似:
- 特征层:实时特征通过 Blink(Flink 阿里版)计算,离线特征通过 MaxCompute 批量产出,统一存储于特征平台 Feather。
- 模型层:采用自研模型服务框架 RTP(Real-Time Prediction),支持 XGBoost/TensorFlow/自定义算法,P99 延迟 < 5ms。
- 决策层:规则引擎 ARE(Ant Risk Engine)与 RTP 结果融合,支持复杂规则网络与动态权重。
- 反馈闭环:交易完成后的 Chargeback、申诉数据回流至 Label Center,自动触发模型重训与 A/B Test。
踩坑经验:
- 特征穿越(Feature Leakage):早期曾出现用"交易是否成功"作为特征训练模型,但线上决策时该特征尚未产生,导致模型离线 AUC 极高、线上效果崩塌。解决方案:严格区分特征时间戳与决策时间戳,所有特征必须满足
feature_time < decision_time。 - PSI 漂移未及时发现:双 11 期间用户行为剧变,模型分数分布整体偏移 15%,误杀率激增。解决方案:引入实时 PSI 监控,PSI > 0.2 自动告警并切换备用模型。
4.2 字节跳动:抖音电商风控系统
字节跳动在抖音电商场景下面临极高并发(日活 6 亿+)与极低延迟(< 30ms)的挑战:
- 实时特征:基于 Flink + ByteKV(自研 KV 存储,兼容 Redis 协议但支持分布式事务),单集群 QPS 达千万级。
- 模型服务:自研 ByteML 推理框架,针对推荐与风控场景深度优化,支持 GPU 动态 batching 与模型量化(INT8)。
- 决策融合:采用 Two-Stage 架构——Stage 1 轻量规则过滤 80% 正常流量;Stage 2 深度模型仅处理剩余 20%,整体吞吐提升 5 倍。
- 反馈闭环:通过 ByteMQ(自研 Kafka 替代)将决策结果与后续用户行为(是否申诉、是否退货)关联,生成 Delayed Label。
踩坑经验:
- Local Cache 数据不一致:多机房部署时,本地 Caffeine 缓存因未同步失效导致不同机房对同一用户打出不同风险分。解决方案:引入 Redis Pub/Sub 广播缓存失效事件,结合版本号机制(MVCC)保证最终一致。
- 模型冷启动:新上线的 Deep Learning 模型因缺乏线上数据,初期效果差于 XGBoost。解决方案:采用 Wide & Deep 架构,Wide 部分(规则 + XGBoost)保证下限,Deep 部分(DNN)随数据积累逐步提升权重。
5. 业务场景对照与注意事项
5.1 加密货币交易所(大型加密货币交易所-like)风险场景映射
| 风险场景 | 事件类型 | 关键特征 | 模型/规则策略 | QPS 估算 | 延迟要求 |
|---|---|---|---|---|---|
| 交易风险 | TX | 7d 交易额、对手方风险分、IP 地理跳变 | XGBoost + 频繁交易规则 | 50K | < 30ms |
| 提现风险 | WITHDRAW | 提现地址画像、24h 提现总额、KYC 等级 | 地址黑名单 + 金额阶梯规则 | 5K | < 50ms |
| 登录风险 | LOGIN | 设备指纹相似度、IP 信誉、暴力破解频次 | 行为生物特征 + 频控规则 | 20K | < 20ms |
| KYC 风险 | KYC | 证件 OCR 置信度、人脸比对分、设备农场检测 | 图像识别模型 + 关联图谱 | 1K | < 500ms(异步) |
| AML 风险 | AML | 资金流向图、混币器关联、暗网地址标签 | 图神经网络 + 链上分析 | 2K | < 200ms(准实时) |
场景详解:交易风险(Transaction Risk)
以 大型加密货币交易所 现货交易为例:
- 触发时机:用户提交订单时,Trading Engine 同步调用 Risk API。
- 特征采集:
- 实时:当前订单金额、交易对波动率、用户当前持仓
- 近实时:最近 1h 订单次数/金额、同 IP 下其他用户交易行为
- 离线:用户生命周期价值(LTV)、历史盈亏比、是否机构客户
- 规则判定:
- 硬规则:单笔 > 100BTC 且 KYC < Level 2 → BLOCK
- 软规则:1h 内 > 50 笔且金额均 < 0.01BTC → 标记为"刷量"
- 模型推理:XGBoost 模型输出风险分,DNN 模型检测异常交易模式(如与历史行为偏离 3 个标准差)。
- 决策融合:规则分数权重 0.3,模型分数权重 0.7,最终分数 > 80 → 要求二次确认(2FA)。
- 反馈闭环:若交易后续被投诉为盗刷,Label=1 回流,触发模型重训。
5.2 常见误区 vs 正确做法
| ❌ 常见误区 | ✅ 正确做法 |
|---|---|
| 用离线特征直接参与实时决策,不做延迟校准 | 所有离线特征标注 snapshot_dt,确保 feature_time < event_time |
| 模型与规则各自为政,分数不统一 | 统一决策融合层,规则分数归一化到 [0, 100] 后再与模型融合 |
| 忽略特征缺失处理,直接传 null 给模型 | 特征服务提供默认值 + 缺失标记(missing indicator),模型训练时同样处理 |
| 模型上线后不再监控,直到业务投诉才处理 | 实时监控 PSI、KS、AUC,设置自动降级阈值 |
| 反馈闭环周期过长(T+30),模型无法快速适应新攻击 | 准实时 Label(Chargeback 24h 内回流)+ 快速重训 pipeline(周级甚至日级) |
| 所有场景用一个通用模型 | 按场景拆分子模型(TX/WITHDRAW/LOGIN),每个模型针对性优化 |
5.3 选型建议
| When to use | When NOT to use |
|---|---|
| 交易决策延迟要求 < 50ms,且需复杂模型推理 | 简单规则即可覆盖(如固定阈值拦截),引入平台反而增加复杂度 |
| 业务方多(交易/提现/登录/KYC),需统一特征口径 | 单一业务、特征维度 < 10,轻量规则引擎更经济 |
| 模型迭代频繁(周级),需 A/B Test 与灰度 | 模型年级不更新,无需复杂 Model Registry |
| 需强审计与可解释性(监管要求) | 内部工具,无合规压力 |
6. FAQ 与高频追问
Q1: 如何保证实时特征与离线特征的一致性?特征穿越怎么解决?
A: 这是风控系统最核心的工程难题之一。
- 统一特征口径:所有特征(实时 + 离线)必须通过同一个 Feature Registry 注册,定义统一的数据类型、计算逻辑、更新频率。离线 Spark ETL 与实时 Flink 任务共用同一套 UDF。
- 时间点一致性:每个特征必须携带
feature_timestamp。实时特征使用 Event Time,离线特征使用 Batch Time。决策时严格校验feature_timestamp <= decision_timestamp。 - 特征回填(Backfill):若发现某特征计算逻辑有误,需对历史数据重新计算并回填到特征宽表,同时更新版本号。模型训练时指定特征版本号,避免新旧特征混用。
- 特征快照:决策瞬间将所有特征(实时 + 离线)打包为 Feature Snapshot 持久化到 Hive/Kafka。后续模型训练直接使用该快照,保证"所见即所得"。
类比:就像新闻报纸的截稿时间——记者(特征生产)必须在截稿前(决策时间)交稿,编辑(决策引擎)只使用截稿前的内容排版。即使后续新闻更新,本期报纸内容不变。
Q2: 模型服务 Triton 的 P99 延迟如何优化到 < 10ms?
A: 多维度优化策略:
- 模型轻量化:XGBoost 限制树深度(max_depth=6)、LightGBM leaf-wise 生长;深度学习使用量化(INT8)+ 剪枝。
- 动态 Batching:Triton 的 Dynamic Batcher 将多个单条请求合并为一个 batch,摊平 GPU 启动开销。配置
preferred_batch_size=16, max_queue_delay_microseconds=100。 - GPU Kernel 优化:TensorRT 将 ONNX 模型编译为 CUDA kernel,避免框架层开销。
- 本地缓存高频结果:对于"同一用户 5s 内重复查询"的场景,在 Feature Service 侧缓存模型结果(注意 TTL 极短)。
- gRPC vs REST:始终使用 gRPC + Proto,序列化开销比 JSON 低 5~10 倍。
- 同机房部署:Triton Server 与 Risk Gateway 部署在同一可用区,网络 RTT < 0.5ms。
Q3: 如果 Triton 模型服务全部宕机,如何保证风控不瘫痪?
A: 多层降级策略(Defense in Depth):
- 规则兜底:Rule Engine 独立部署,不依赖模型服务。硬规则(黑名单、固定阈值)始终可用。
- 规则权重动态调整:模型不可用时,决策融合引擎将
rule_weight自动提升至 1.0,完全由规则驱动。 - 本地模型副本:在 Risk Gateway 节点本地嵌入轻量模型(如 XGBoost 4MB 模型),仅处理最高频的场景。
- 熔断器(Circuit Breaker):Sentinel 监控 Triton 调用,连续失败 5 次后自动 OPEN,后续请求直接走规则分支,每 30s 尝试 HALF_OPEN 探测恢复。
- 预计算缓存:对高频用户(如机构客户)的模型分数预计算并缓存,模型宕机时直接读取缓存。
Q4: 如何处理极端情况下 Kafka 消息积压(Backpressure)?
A: Kafka 积压会直接导致实时特征滞后,进而引发漏判。应对策略:
- 生产端限流:业务服务通过 Sentinel 限流,避免突发流量压垮特征 pipeline。
- 消费端扩容:Flink/Consumer 支持水平扩容,增加 partition 数与 consumer 实例数(1 partition = 1 consumer 线程)。
- 跳过非关键特征:积压严重时,降级处理低优先级特征(如"用户最近 100 笔交易对手方列表"),保留核心特征(如"24h 交易金额")。
- 消费限速(Throttling):设置
max.poll.records与fetch.max.bytes,避免单次消费过多导致处理超时反复 rebalance。 - 监控与告警:Kafka Consumer Lag 超过阈值(如 100K 条)立即告警,自动触发扩容脚本。
Q5: 风险评分平台的决策结果如何支持监管审计与可解释性?
A: 监管(如 FATF、SEC)要求风控决策必须可解释、可追溯。
- 全链路审计日志:每笔决策记录完整上下文——输入特征(含版本)、规则命中列表、模型分数、融合权重、最终决策。存储于不可篡改的日志系统(如 Elasticsearch + WORM 存储)。
- SHAP / LIME 可解释性:模型推理时同步计算 SHAP 值,输出"Top 5 影响特征"(如"IP 地理跳变贡献 +35% 风险分")。
- 规则解释:规则引擎返回每条命中规则的自然语言描述(如"用户 24h 内提现超过 10BTC,触发 Level 3 风控规则")。
- 决策快照保留期:原始特征快照与决策结果保留 7 年(满足金融监管要求)。
- 申诉与复核接口:提供
/risk/appealAPI,允许用户申诉并被拦截的交易,人工审核后更新 Label。
Q6: 模型 A/B Test 如何设计?灰度发布流程是什么?
A:
- 流量切分:按 user_id 哈希分桶(如 1000 桶),初始将 1% 流量(10 桶)切给新模型 V2,99% 走旧模型 V1。
- 影子模式(Shadow Mode):新模型先以"只读"方式运行,输出分数但不影响实际决策,用于对比 V1/V2 的差异分布(PSI、KS)。
- 指标监控:关注误杀率(False Positive Rate)、漏杀率(False Negative Rate)、决策延迟。需运行至少 1~2 周覆盖不同业务周期(工作日 vs 周末)。
- 逐步放量:影子模式验证通过后,按 1% → 5% → 20% → 50% → 100% 阶梯放量,每阶段观察 24h 指标。
- 一键回滚:通过配置中心(Nacos/Apollo)动态切换模型版本号,异常时 10s 内回滚到 V1。
Q7: 如何设计多地域(Multi-Region)部署下的特征一致性?
A: 大型加密货币交易所 用户分布全球,需在新加坡、东京、法兰克福、弗吉尼亚多地域部署:
- Redis Global Cache:使用 Redis Enterprise 的 Active-Active 或 AWS ElastiCache Global Datastore,跨地域异步复制(最终一致)。实时特征写本地 Redis,同步到其他地域。
- StarRocks 就近查询:每个地域独立 StarRocks 集群,离线特征通过 Spark 批量同步(T+1)。一致性要求高的特征通过 Kafka MirrorMaker 2 近实时同步。
- 模型服务无状态:Triton Server 无状态,每个地域独立部署,模型版本通过 MLflow 统一分发。
- 数据主权合规:欧盟用户数据不出 EU,需在法兰克福独立部署完整集群,仅汇总脱敏后的模型指标到中心监控。
记忆口诀:
- 特征采集:Kafka Flink 实时跑,Hive Spark 离线造。
- 特征存储:Redis 快查 StarRocks 挖,本地缓存扛并发。
- 模型服务:Triton 动态 batching 强,多版本灰度不慌。
- 决策融合:规则先行模型补,加权融合出分数。
- 反馈闭环:结果回流 Label 收,PSI 漂移重训走。